從模型戰打到成本戰!Google開發「Frozen v2」大砍Gemini運算成本
Google正開發專用晶片,目的是降低Gemini AI推理的電力與成本。
(圖/Alphabet Inc)
Google已著手開發專為生成式人工智慧(AI)模型「Gemini」設計的專用晶片。這款晶片的應用範圍雖比現有負責通用AI運算的張量處理器(TPU)更窄,但目標是大幅降低Gemini推理所需的電力與成本。隨著AI競爭從模型效能轉向服務成本與效率,科技巨頭的客製化晶片開發也加速推進。
依美國科技媒體《The Information》20日(當地時間)報導,Google正在內部開發代號「Frozen v2」的伺服器用AI晶片。該晶片將Gemini的部分運算結構直接實作於半導體電路,減少反覆解讀軟體指令、或在記憶體與運算裝置之間搬移資料的過程,藉此提升回應速度與電力效率。
開發團隊預估,Frozen v2每單位電力可處理的Token數量將提升6至10倍。Token是AI處理句子時的基本單位,這意味著相同電力下能處理更多查詢,可同時降低資料中心擴建負擔與服務營運成本。
這項專案與激增的AI需求密切相關。《The Information》指出,Google Cloud因AI需求激增面臨運算資源不足,甚至無法即時消化部分外部客戶訂單。Google判斷僅靠額外採購GPU已難以解決成本與電力問題,因此將開發策略轉為模型、晶片、伺服器三者共同最佳化。
在生成式AI事業中,推理成本比訓練成本更左右長期獲利能力。模型訓練完成後,每當使用者發出查詢仍需反覆執行運算,因此隨著搜尋、文件撰寫、影片分析等Gemini應用範圍擴大,需處理的Token數量也快速攀升。專用晶片的效率若獲驗證,AI服務的營運成本可望下降。
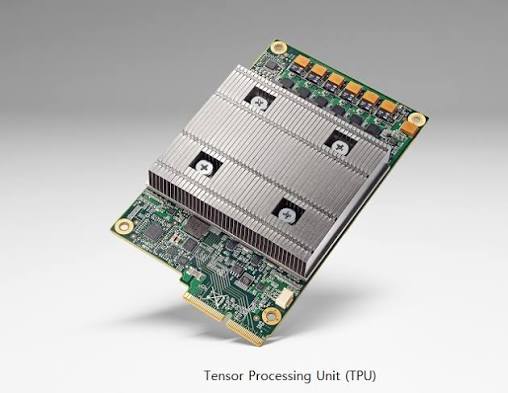
Google開發的TPU。(圖/Alphabet Inc)
「Frozen」這個名稱意指將模型的核心結構「固定」於晶片。GPU或TPU是支援多種AI模型的通用晶片,而針對特定模型的專用晶片,可藉由減少非必要功能來提升效率;但若模型結構發生重大變更,晶片也必須隨之修改,這是它的限制。軟體以數月為單位更新,半導體開發卻需數年,因此如何拿捏模型結構在電路中的反映程度,將是關鍵課題。
Google目標最快2028年正式導入,但目前開發仍在初期階段,是否實際量產尚未確定。Google對此表示:「我們持續研究新技術,但並非所有專案都能發展為實際產品。」Frozen晶片並非以取代現有TPU為目標,而是被定位為專門負責Gemini推理等反覆性大規模運算的獨立產品線。
Google自行研發AI半導體已逾10年。今年公布的第8代TPU分為訓練用的「TPU 8t」與推理用的「TPU 8i」,Google表示兩款產品的每單位電力效能較前一代Ironwood提升達2倍。Google的策略是讓通用TPU與Gemini專用晶片並行運作,藉此分離訓練與推理功能。
這項開發也可能對以輝達(NVIDIA)為核心的AI半導體市場帶來影響。輝達GPU憑藉通用性與軟體生態系主導市場,但經營大規模AI服務的科技巨頭,為降低成本與確保供應,正加速擴大客製化半導體開發。Google若能驗證Gemini專用晶片的效率,Microsoft、Amazon、Meta等公司也可能加快模型與半導體共同設計的策略。
不過專用晶片要立即取代輝達GPU並不容易。在AI模型仍快速變化的開發階段,能處理多樣化任務的通用晶片仍具優勢。
業界人士表示:「專用晶片要在模型結構與服務穩定之後,於反覆處理大規模推理的環境中才具高度競爭力。」他並指出:「Google勢必將重心放在讓Gemini與資料中心、網路、軟體共同最佳化以降低營運成本,而非追求打造效能最高的晶片。」